Planejamento de consultas no PostgreSQL: lendo o EXPLAIN e projetando índices
Como o planejador estima custo e seletividade a partir das estatísticas, como ler cada linha de um EXPLAIN (ANALYZE, BUFFERS), por que um índice existente é ignorado e como projetar índices compostos, parciais e cobertos sem pagar demais na escrita.
Por Alexandre Martins · · 8 min de leitura
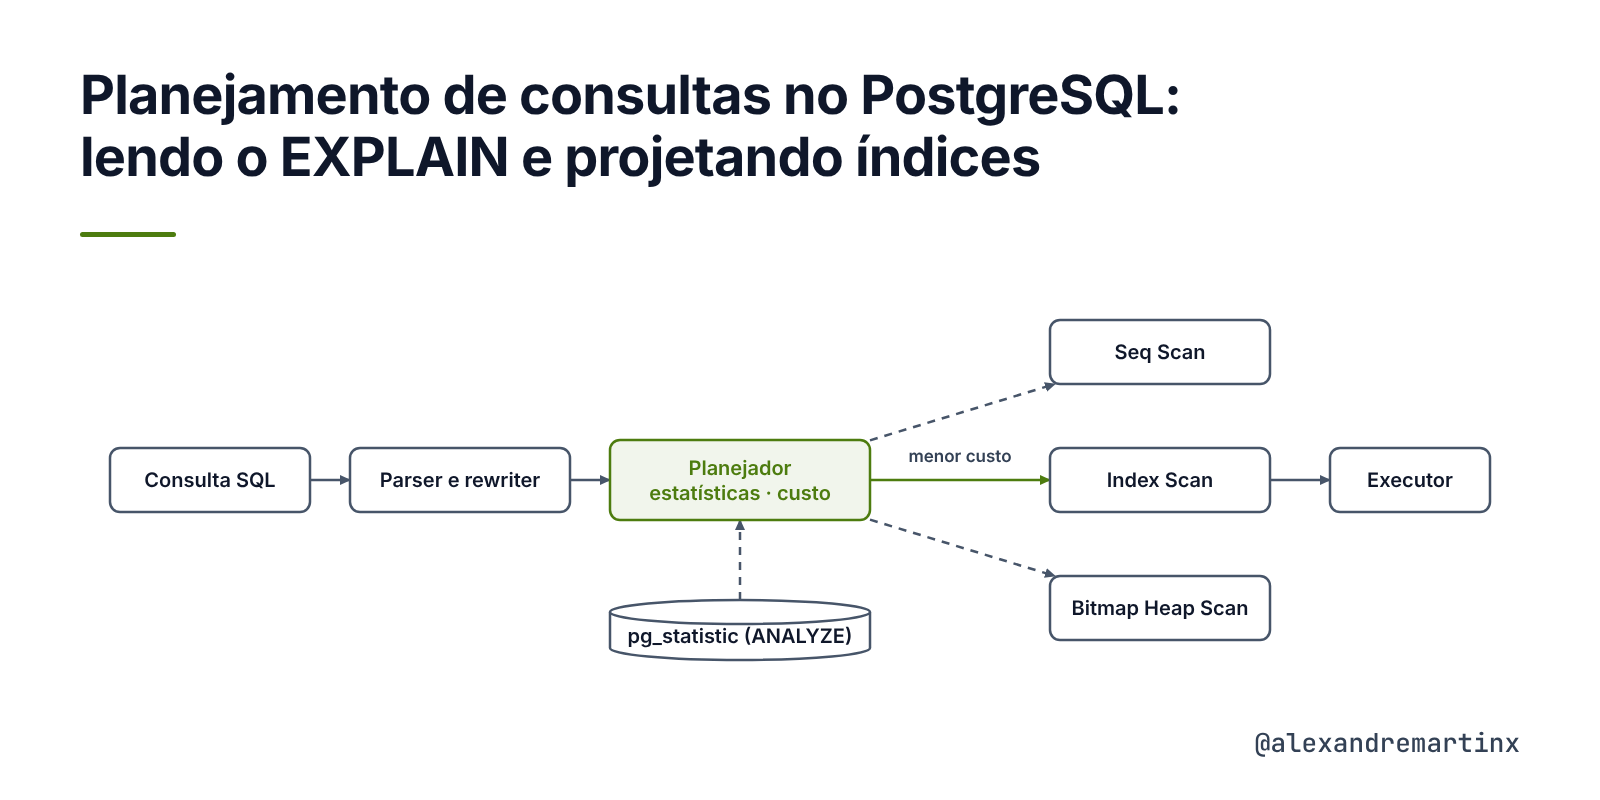
Considere uma tabela de pedidos com 2 milhões de linhas e uma consulta que devolve os últimos 20 pedidos de um cliente. Sem o índice certo, o PostgreSQL lê a tabela inteira, descarta 1.999.973 linhas, ordena as 27 restantes e responde em 119 ms. Com um índice composto em cliente e data, lê 23 páginas e responde em 0,09 ms.
O planejador não escolhe o plano lento por erro. Ele escolhe o de menor custo estimado com os índices que existem e as estatísticas que tem. Quando o plano é ruim, a causa está em um desses insumos ou na consulta, e o EXPLAIN mostra qual.
Como ler o plano que o PostgreSQL escolheu, descobrir por que ele não usou o índice esperado e projetar índices que sirvam às consultas sem encarecer cada escrita?
Como o planejador escolhe um plano
Para cada consulta, o planejador enumera planos possíveis e atribui a cada nó um custo em unidades arbitrárias. A documentação fixa seq_page_cost em 1.0 e os demais parâmetros em relação a ele, como cpu_tuple_cost 0.01 por linha e random_page_cost 4.0 por página lida fora de ordem. O plano de menor custo total vence. Em SSD, 1.1 é um valor usual.
O custo depende de quantas linhas cada nó vai produzir, e essa estimativa vem das estatísticas. O ANALYZE amostra a tabela e grava em pg_statistic o número de valores distintos, os valores mais comuns com suas frequências e um histograma dos demais. A amostra tem 300 linhas por unidade de default_statistics_target, 30.000 com o padrão 100. O autovacuum roda ANALYZE após 10% de linhas alteradas.
Cada condição vira uma seletividade. Para cliente_id = 4242, com 48.900 valores distintos e nenhum dominante, a estimativa é 2 milhões divididos por 48.900, cerca de 41 linhas. Para status = 'ENTREGUE', o valor está na lista dos mais comuns com frequência 0,849, e a estimativa é 1,7 milhão. Essa diferença decide entre índice e varredura.
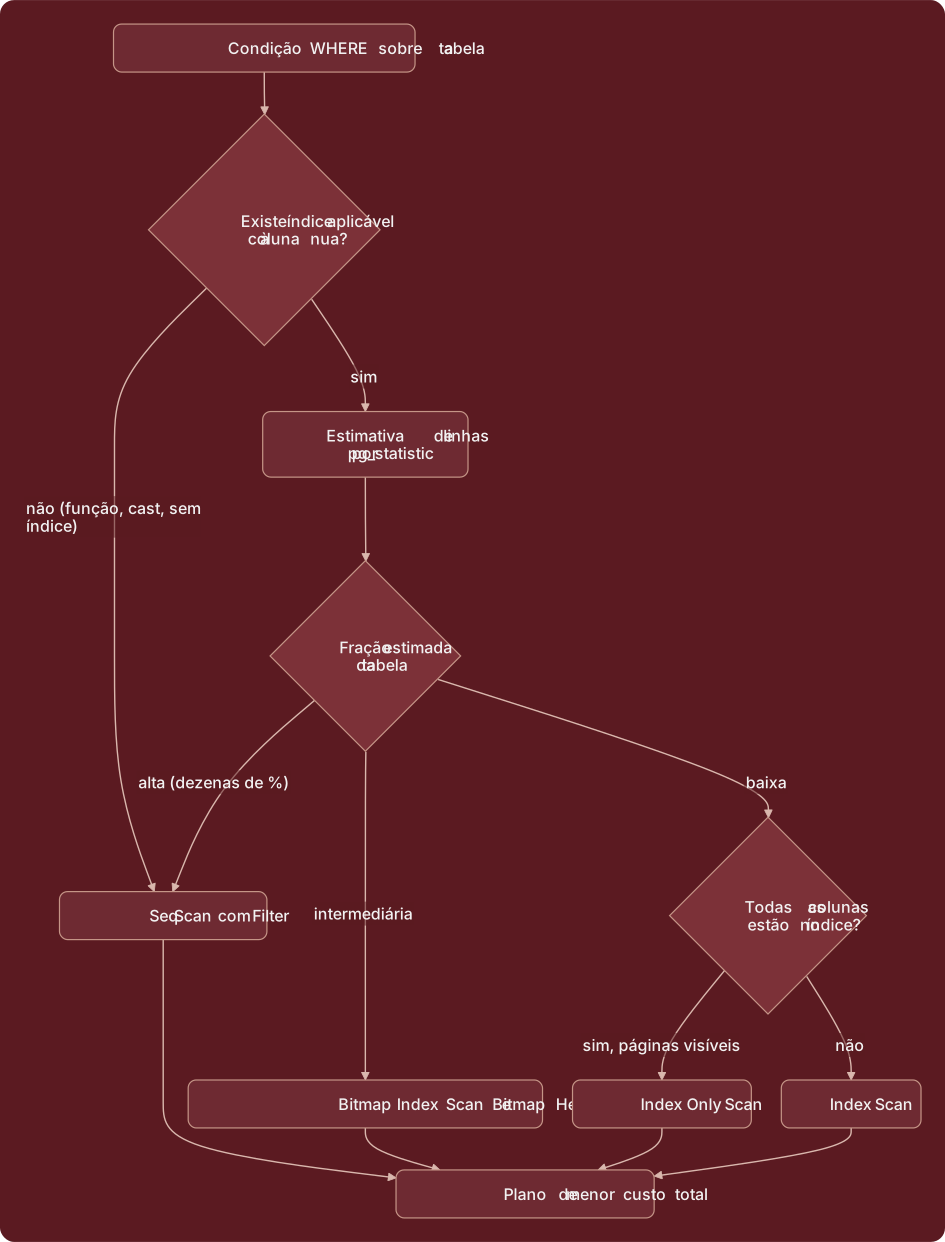
Ver o fluxograma em texto (Mermaid)
flowchart TD
  consulta["Condição WHERE sobre a tabela"] --> indice{"Existe índice aplicável\nà coluna nua?"}
  indice -- "não (função, cast, sem índice)" --> seq["Seq Scan com Filter"]
  indice -- "sim" --> estat["Estimativa de linhas\npor pg_statistic"]
  estat --> selet{"Fração estimada\nda tabela"}
  selet -- "alta (dezenas de %)" --> seq
  selet -- "intermediária" --> bitmap["Bitmap Index Scan e Bitmap Heap Scan"]
  selet -- "baixa" --> colunas{"Todas as colunas\nestão no índice?"}
  colunas -- "sim, páginas visíveis" --> ionly["Index Only Scan"]
  colunas -- "não" --> iscan["Index Scan"]
  seq --> custo["Plano de menor custo total"]
  bitmap --> custo
  ionly --> custo
  iscan --> custo
Lendo o EXPLAIN (ANALYZE, BUFFERS)
O EXPLAIN mostra o plano como árvore, com os filhos recuados e executados antes dos pais. Cada nó traz cost=inicial..total, rows estimadas e width em bytes. Com ANALYZE, a consulta é executada e cada nó ganha actual time, rows reais e loops. Tempo e linhas são médias por execução, a multiplicar por loops. Com BUFFERS, cada nó mostra as páginas de 8 kB vindas do cache (hit) e do disco (read).
Seq Scan lê a tabela inteira e aplica Filter, com Rows Removed by Filter medindo o desperdício. Index Scan percorre o índice por Index Cond e visita o heap a cada entrada. Index Only Scan responde só com o índice, e Heap Fetches conta as idas ao heap por falta de bit no mapa de visibilidade. Bitmap Heap Scan monta um mapa de páginas a partir de um Bitmap Index Scan e lê o heap em ordem física, para seletividade intermediária.
Nested Loop executa o lado interno uma vez por linha do externo, e serve quando o externo tem poucas linhas e o interno tem índice. Hash Join constrói uma tabela hash do lado menor e a consulta para cada linha do maior. Merge Join percorre os dois lados ordenados pela chave.
Exemplo: tabela de pedidos e seus planos
Os planos foram medidos com 2 milhões de pedidos de 50.000 clientes, random_page_cost 1.1 e paralelismo desligado.
CREATE TABLE pedido (
  id          BIGSERIAL      PRIMARY KEY,
  cliente_id  INTEGER        NOT NULL REFERENCES cliente (id),
  status      TEXT           NOT NULL,          -- CRIADO, PAGO, ENVIADO, ENTREGUE, CANCELADO
  total       NUMERIC(12,2)  NOT NULL,
  criado_em   TIMESTAMPTZ    NOT NULL
);

-- Igualdade, depois ordenação; total como carga para Index Only Scan.
CREATE INDEX pedido_cliente_criado_idx ON pedido (cliente_id, criado_em DESC) INCLUDE (total);
-- Parcial: só os 3% de pedidos pendentes entram no índice.
CREATE INDEX pedido_pendentes_idx ON pedido (criado_em) WHERE status IN ('CRIADO', 'PAGO');
CREATE INDEX pedido_criado_em_idx ON pedido (criado_em);
Antes do índice composto, a consulta SELECT * FROM pedido WHERE cliente_id = 4242 ORDER BY criado_em DESC LIMIT 20 produz:
Limit  (cost=41668.09..41668.14 rows=20 width=34) (actual time=119.409..119.414 rows=20 loops=1)
  ->  Sort  (cost=41668.09..41668.19 rows=41 width=34) (actual time=119.407..119.410 rows=20 loops=1)
        Sort Key: criado_em DESC
        ->  Seq Scan on pedido  (cost=0.00..41667.00 rows=41 width=34) (actual time=5.169..119.340 rows=27 loops=1)
              Filter: (cliente_id = 4242)
              Rows Removed by Filter: 1999973
              Buffers: shared hit=16667
Execution Time: 119.449 ms
De baixo para cima: o Seq Scan leu as 16.667 páginas da tabela, todas em cache, e descartou 1.999.973 linhas para ficar com 27. A estimativa de 41 estava próxima, então o problema não é estatística, é a falta de um caminho de acesso. O Sort ordenou 27 linhas em memória e o Limit parou em 20, mas o custo já tinha sido pago embaixo.
Com pedido_cliente_criado_idx, a mesma consulta e uma segunda, que pede só data e total de 2026, produzem:
Limit  (cost=0.43..23.31 rows=20 width=34) (actual time=0.049..0.078 rows=20 loops=1)
  ->  Index Scan using pedido_cliente_criado_idx on pedido  (cost=0.43..47.34 rows=41 width=34) (actual time=0.048..0.074 rows=20 loops=1)
        Index Cond: (cliente_id = 4242)
        Buffers: shared hit=20 read=3
Execution Time: 0.093 ms

Index Only Scan using pedido_cliente_criado_idx on pedido  (cost=0.43..1.87 rows=17 width=14) (actual time=0.008..0.011 rows=9 loops=1)
  Index Cond: ((cliente_id = 4242) AND (criado_em >= '2026-01-01 00:00:00-03'::timestamp with time zone))
  Heap Fetches: 0
  Buffers: shared hit=4
Execution Time: 0.020 ms
O Index Scan percorre as entradas do cliente já na ordem de criado_em DESC, então não há Sort, e o Limit interrompe a leitura na vigésima linha: rows=20 no nó do índice. No segundo plano, a consulta pede só colunas do índice, e o Index Only Scan responde com 4 páginas e nenhuma visita ao heap. Heap Fetches igual a zero depende de o VACUUM ter marcado as páginas como visíveis a todas as transações.
A junção de um relatório semanal, 19.054 pedidos de 50.000 clientes, mostra os outros nós. O planejador lê pedido por Bitmap Heap Scan sobre pedido_criado_em_idx, porque as linhas estão espalhadas por 11.402 páginas, e monta um hash de 3 MB com o Seq Scan de cliente. O Hash Join entre os dois leva 78 ms. Com um único cliente, o plano troca para Nested Loop com Index Only Scan e responde em 0,05 ms.
Por que um índice é ignorado
Quatro causas cobrem a maioria dos casos:
- Seletividade baixa. Com um índice em status, a consulta por 'ENTREGUE' (85% das linhas) usa Seq Scan, porque visitar 1,7 milhão de entradas do índice e depois o heap custa mais que ler a tabela. Por 'CRIADO' (1%), usa o índice.
- Função sobre a coluna. WHERE date(criado_em) = '2026-10-01' não usa o índice em criado_em: Filter com 1.997.276 linhas removidas em 280 ms. Reescrita como intervalo entre '2026-10-01' e '2026-10-02', usa Bitmap Heap Scan e leva 4 ms.
- Tipo incompatível. Um parâmetro numeric comparado com a coluna id, bigint, aparece como Filter: ((id)::numeric = '4242'::numeric). O cast cai sobre a coluna, a chave primária é ignorada e uma linha custa 16.667 páginas e 331 ms. Com parâmetro inteiro, Index Scan em 7 páginas.
- Estatísticas ausentes. Em uma cópia da tabela sem ANALYZE, o planejador estimou 7.099 linhas para cliente_id = 4242 contra 27 reais. Depois do ANALYZE, 41.
Projeto de índices
Em um índice B-tree composto, a ordem das colunas segue a regra da documentação: igualdades primeiro, depois a primeira coluna com desigualdade ou ordenação. Em pedido_cliente_criado_idx, cliente_id entra por igualdade e criado_em por ordenação e faixa. Invertido, o índice serviria a consultas por data, não ao acesso por cliente.
O índice parcial indexa só as linhas de um predicado. O de pedidos pendentes ocupa 1,3 MB contra 43 MB de um índice completo em criado_em. A consulta precisa trazer o mesmo predicado, ou um que o implique.
O INCLUDE adiciona colunas de carga fora da chave, e é o que permite o Index Only Scan da segunda consulta. O custo é o tamanho: o índice composto com total ocupa 77 MB em uma tabela de 130 MB. Cada índice é uma escrita a mais por INSERT e UPDATE, com o WAL correspondente.
Ferramentas de diagnóstico
O pg_stat_statements agrega as consultas executadas, normalizadas por parâmetros, com calls, total_exec_time, rows e shared_blks_read, e exige shared_preload_libraries e reinício. O auto_explain grava no log o plano das consultas acima de auto_explain.log_min_duration, com log_analyze e log_buffers para capturar o plano real de uma execução lenta.
Desafios
As estatísticas tratam colunas como independentes. Para status = 'CANCELADO' AND cancelado_em IS NOT NULL, o planejador multiplica as duas seletividades e subestima o resultado. CREATE STATISTICS com dependencies ou mcv corrige a estimativa.
Consultas parametrizadas podem receber um plano genérico após cinco execuções, calculado sem conhecer o valor. Para colunas de distribuição desigual, como status, o plano genérico serve a 'CRIADO' e falha com 'ENTREGUE', e plan_cache_mode força o plano específico.
Os tempos do EXPLAIN ANALYZE dependem do cache: a segunda execução lê de shared buffers o que a primeira leu do disco, e a coluna read mostra a diferença. Por fim, o plano muda com os dados. Uma tabela que cresce dez vezes cruza o limiar em que o Nested Loop deixa de ser barato.
Boas práticas
- Leia o EXPLAIN de baixo para cima e compare rows estimadas com rows reais em cada nó antes de indexar.
- Projete índices compostos com as colunas de igualdade primeiro e a de ordenação ou faixa por último.
- Use índices parciais para subconjuntos pequenos e frequentes, e repita o predicado do índice na consulta.
- Acrescente colunas com INCLUDE só quando um Index Only Scan frequente justificar o tamanho extra.
- Escreva condições sobre a coluna nua, com intervalos em vez de funções e parâmetros do mesmo tipo da coluna.
- Execute ANALYZE depois de cargas em lote e crie estatísticas estendidas para colunas correlacionadas.
- Mantenha pg_stat_statements ativo e revise as consultas de maior tempo total quando o volume mudar.
Conclusão
O planejador trabalha com dois insumos que o projetista controla: os índices que existem e as estatísticas que descrevem os dados. O EXPLAIN (ANALYZE, BUFFERS) verifica os dois, porque mostra o caminho escolhido, o erro da estimativa e as páginas que o caminho custou.
Projetar índices é decidir, consulta por consulta, quais colunas entram, em que ordem, com que predicado e com que carga, e aceitar o custo de escrita de cada decisão. Ler o plano antes e depois de cada índice transforma a decisão em medição.
Referências
- PostgreSQL, Using EXPLAIN. https://www.postgresql.org/docs/current/using-explain.html
- PostgreSQL, Statistics Used by the Planner. https://www.postgresql.org/docs/current/planner-stats.html
- PostgreSQL, Multicolumn Indexes. https://www.postgresql.org/docs/current/indexes-multicolumn.html
- PostgreSQL, Partial Indexes. https://www.postgresql.org/docs/current/indexes-partial.html
- PostgreSQL, Index-Only Scans and Covering Indexes. https://www.postgresql.org/docs/current/indexes-index-only-scans.html
- PostgreSQL, pg_stat_statements. https://www.postgresql.org/docs/current/pgstatstatements.html
Assuntos: PostgreSQL, SQL, Database Performance, Indexing, Backend Development
Continue lendo
- Transactional Outbox: publicação confiável de eventos a partir do banco de dados — Como gravar o evento na mesma transação do agregado e entregá-lo ao broker por polling ou por captura do log de transações, com garantia at-least-once, ordem por agregado e deduplicação no consumidor.
- Idempotência em APIs distribuídas: chaves, persistência e janelas de validade — Como garantir que uma operação de escrita repetida por retry produza exatamente um efeito, com Idempotency-Key, armazenamento transacional e tratamento de concorrência.
- Entrega progressiva: feature flags, canary e blue-green — Como separar deploy de release com flags avaliadas por hash determinístico, escolher entre blue-green e canary, e deixar métricas de guarda decidirem a promoção ou o rollback com Argo Rollouts.
Quer aplicar isto no seu sistema? Fale com a MFactor: contato ou WhatsApp +55 (19) 99778-9831.