Entrega progressiva: feature flags, canary e blue-green
Como separar deploy de release com flags avaliadas por hash determinístico, escolher entre blue-green e canary, e deixar métricas de guarda decidirem a promoção ou o rollback com Argo Rollouts.
Por Alexandre Martins · · 8 min de leitura
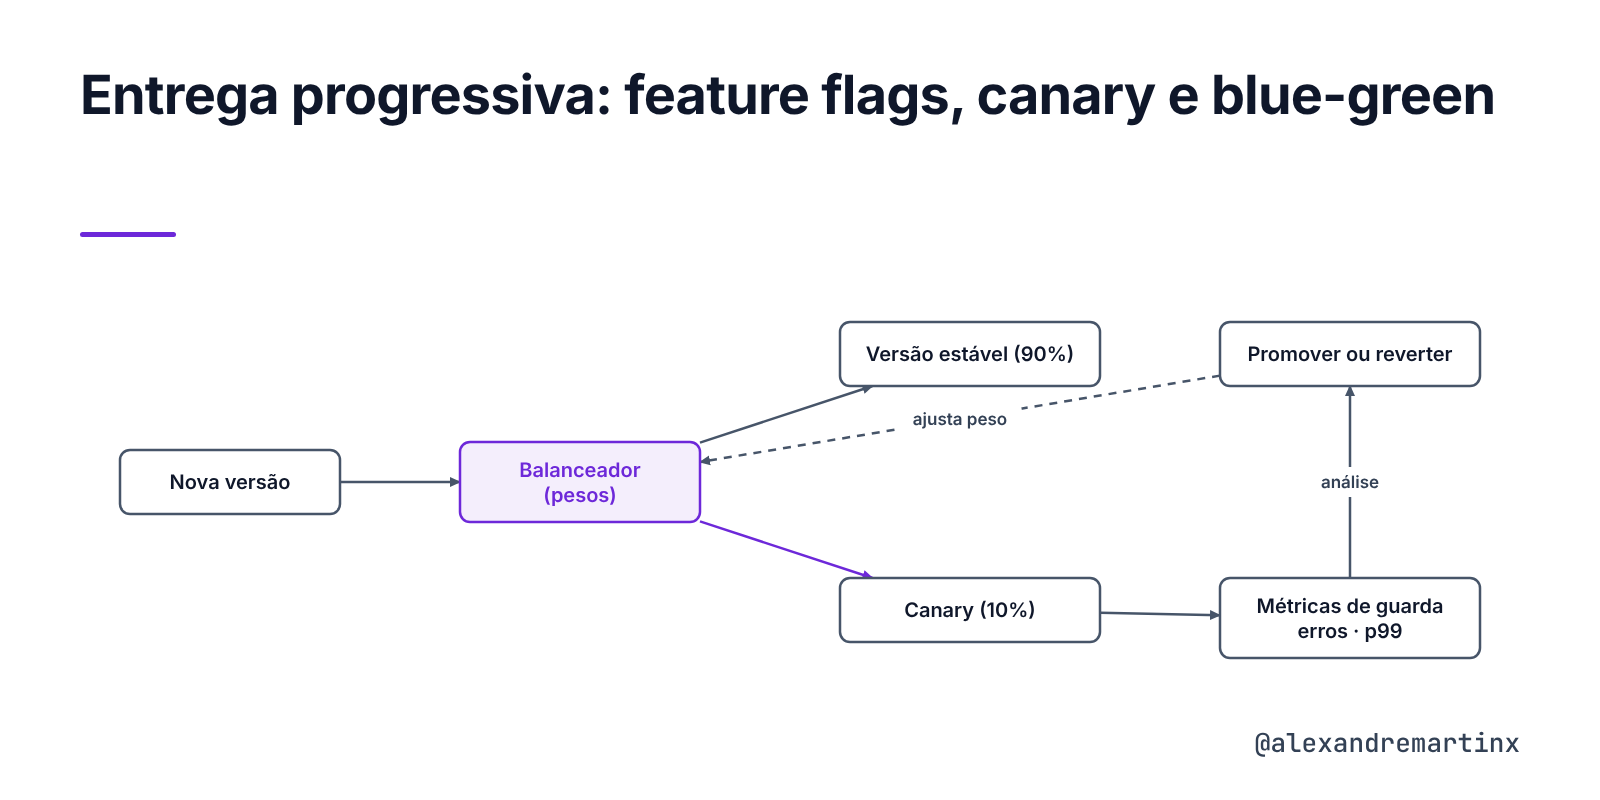
Um deploy coloca uma versão nova do código nos servidores. Um release coloca um comportamento novo diante dos usuários. Na maioria dos sistemas, os dois acontecem no mesmo instante: a versão sobe e todos os usuários a veem. Cada deploy vira uma aposta de tudo ou nada, e a única defesa contra um defeito é o rollback, que expõe todos os usuários enquanto dura.
Separar os dois eventos muda a natureza do risco. O código pode estar em produção sem que nenhum usuário o execute, pode ser executado por 1 % dos usuários enquanto métricas o observam, e pode ser desligado sem um novo deploy. O custo é uma camada a mais de decisão em tempo de execução, que precisa ser determinística, observável e temporária.
Como separar o momento em que o código chega à produção do momento em que o usuário o vê, e limitar o alcance de cada versão nova até que as métricas a aprovem?
Deploy e release como eventos distintos
Entrega progressiva (progressive delivery) é o conjunto de técnicas que expõe uma mudança a uma fração controlada do tráfego antes de expô-la a todos. A fração pode ser definida por usuário, com feature flags, ou por requisição, com roteamento entre versões. Os dois mecanismos se combinam: a versão nova sobe como canário com a flag desligada, e a flag é aberta depois que a infraestrutura se mostra estável.
A separação exige que as versões N e N+1 convivam no mesmo cluster, no mesmo banco e, no caso das flags, no mesmo processo como dois caminhos de código. Essa convivência é a origem de quase todos os desafios tratados adiante.
Feature flags: tipos e avaliação
Pete Hodgson, em artigo publicado no site de Martin Fowler, classifica as flags em quatro categorias. Release toggles escondem código incompleto para permitir trunk-based development e duram dias ou semanas. Experiment toggles dividem usuários em coortes para testes A/B e precisam de atribuição estável por usuário. Ops toggles desligam ou degradam uma funcionalidade sob carga. Permissioning toggles liberam funcionalidades para grupos específicos, como clientes beta, e duram mais que as outras.
A avaliação por porcentagem não pode usar um sorteio a cada requisição. Com Math.random, o mesmo usuário veria o checkout novo em uma página e o antigo na seguinte, e as réplicas discordariam entre si. A avaliação precisa ser determinística: um hash do identificador do usuário, da chave da flag e de uma semente, reduzido a 10.000 buckets, coloca o usuário em uma posição fixa. A flag está ligada para ele se a posição for menor que a porcentagem configurada. Incluir a chave da flag no hash impede que os mesmos 10 % de usuários caiam em todas as flags. Trocar a semente redistribui os usuários quando um experimento recomeça.
Toda flag tem ciclo de vida. Ela nasce com um dono e uma data prevista de remoção, cresce de 1 % a 100 % e morre quando o caminho antigo é apagado do código. Hodgson chama de carrying cost o custo da flag que permanece após o release: dois caminhos para testar e uma configuração que pode ser alterada por engano.
Blue-green e canary
No blue-green, descrito por Fowler, existem dois ambientes completos. Um atende a produção enquanto o outro recebe a versão nova e é testado sem tráfego real. A promoção é uma troca no roteador, e o rollback é a troca inversa. A troca é instantânea e binária: 100 % dos usuários passam para a versão nova de uma vez. O custo é o dobro da capacidade durante a janela, e as transações recebidas pelo ambiente novo precisam ser compatíveis com o antigo caso a troca inversa ocorra.
No canary, a versão nova recebe uma fração do tráfego, que cresce em passos enquanto métricas são observadas. O defeito que escapou dos testes atinge 5 % dos usuários, não todos. O custo é tempo, e a exigência é ter métricas separadas por versão. Sem um traffic router (Istio, NGINX, ALB), a divisão se aproxima pela proporção de réplicas, e 5 % de 10 pods vira 1 pod, isto é, 10 %.
Nas duas estratégias o banco é compartilhado, e o esquema precisa servir às versões N e N+1 ao mesmo tempo. Fowler recomenda separar a mudança de esquema do deploy da aplicação, em uma sequência em que o esquema passa a suportar as duas versões antes que a nova suba. Esse tema volta em artigo próprio sobre migrações sem indisponibilidade.
Análise automática de canary
Um canary observado por uma pessoa em um painel tem o alcance da atenção dessa pessoa. A análise automática substitui o painel por métricas de guarda com limiares explícitos. As duas métricas mínimas são a taxa de sucesso (requisições sem resposta 5xx sobre o total) e a latência p99, medidas apenas nos pods do canário. Comparar com um limiar absoluto é mais simples. Comparar com o conjunto estável no mesmo intervalo é mais preciso, porque descarta variações que afetam as duas versões.
A análise é uma sequência de medições em intervalo fixo. Um número configurado de falhas aborta o rollout: o peso do canário volta a zero, e o conjunto estável continua atendendo. Um resultado inconclusivo, como uma consulta sem dados, pausa o rollout para decisão humana em vez de promover por omissão.
Com 5 % do tráfego, a amostra do canário é pequena, e a taxa de erro oscila com poucos eventos. Intervalos mais longos e um limite de falhas maior que 1 reduzem o abort por ruído. O primeiro passo detecta falhas grosseiras, como pods que não sobem, e os passos seguintes, com mais tráfego, detectam regressões finas.
Exemplo em TypeScript e Argo Rollouts
A função de avaliação abaixo implementa o bucket determinístico com SHA-256. O kill switch da flag vence qualquer outra regra, a lista de permitidos cobre o caso de permissioning, e a porcentagem usa a resolução de 0,01 %.
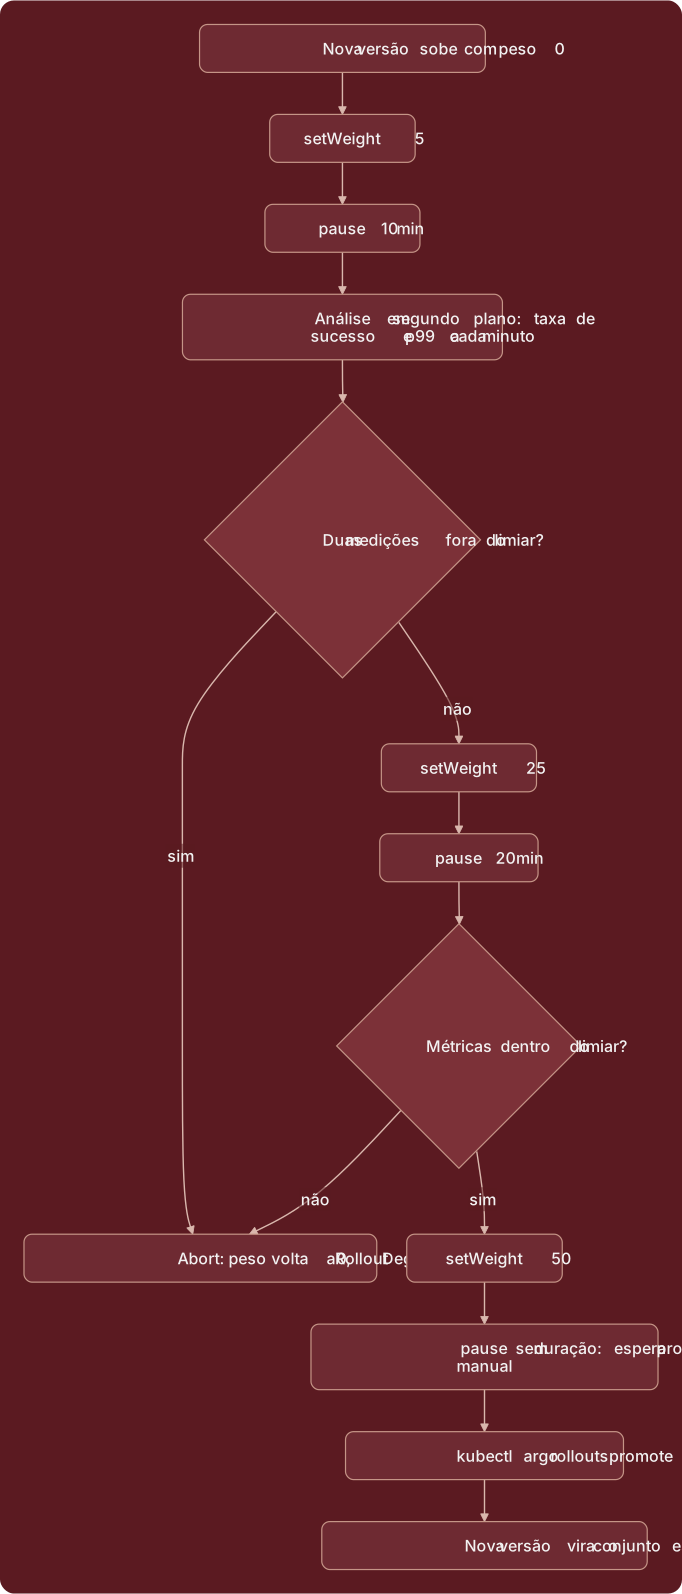
Ver o fluxograma em texto (Mermaid)
flowchart TD
  deploy["Nova versão sobe com peso 0"] --> w5["setWeight 5"]
  w5 --> p10["pause 10 min"]
  p10 --> analise["Análise em segundo plano: taxa de sucesso e p99 a cada minuto"]
  analise --> falhas{"Duas medições fora do limiar?"}
  falhas -- "sim" --> abort["Abort: peso volta a 0, Rollout Degraded"]
  falhas -- "não" --> w25["setWeight 25"]
  w25 --> p20["pause 20 min"]
  p20 --> falhas2{"Métricas dentro do limiar?"}
  falhas2 -- "não" --> abort
  falhas2 -- "sim" --> w50["setWeight 50"]
  w50 --> manual["pause sem duração: espera promoção manual"]
  manual --> promove["kubectl argo rollouts promote"]
  promove --> estavel["Nova versão vira o conjunto estável"]
import { createHash } from "node:crypto";
type TipoFlag = "release" | "experiment" | "ops" | "permission";
interface Flag {
chave: string;
tipo: TipoFlag;
ativa: boolean; // interruptor geral: desligado vence qualquer regra
porcentagem: number; // 0 a 100
semente: string; // trocar a semente redistribui os usuários
permitidos?: string[]; // identificadores sempre incluídos
}
interface Contexto { usuarioId: string }
const BUCKETS = 10_000; // resolução de 0,01 %
export function bucket(chaveFlag: string, semente: string, identificador: string): number {
const digest = createHash("sha256").update(`${chaveFlag}:${semente}:${identificador}`).digest();
return digest.readUInt32BE(0) % BUCKETS; // mesmo usuário, mesma flag, mesmo bucket em toda réplica
}
export function avaliar(flag: Flag, ctx: Contexto): boolean {
if (!flag.ativa) return false;
if (flag.permitidos?.includes(ctx.usuarioId)) return true;
return bucket(flag.chave, flag.semente, ctx.usuarioId) < flag.porcentagem * (BUCKETS / 100);
}
const novoCheckout: Flag = {
chave: "novo-checkout", tipo: "release", ativa: true, porcentagem: 10, semente: "2026-11",
};
export function renderizarCheckout(ctx: Contexto) {
return avaliar(novoCheckout, ctx) ? checkoutV2(ctx) : checkoutV1(ctx);
}O manifesto a seguir substitui o Deployment por um Rollout do Argo Rollouts. Os passos alternam setWeight e pause: a pausa com duração avança sozinha, e a pausa vazia espera o comando de promoção. A análise em segundo plano começa no segundo passo e roda até o fim do rollout.
apiVersion: argoproj.io/v1alpha1
kind: Rollout
metadata:
  name: checkout
spec:
  replicas: 10
  selector:
    matchLabels: { app: checkout }
  template:
    metadata:
      labels: { app: checkout }
    spec:
      containers:
        - name: checkout
          image: registry.exemplo.com/checkout:2.4.0
          ports: [{ containerPort: 8080 }]
  strategy:
    canary:
      canaryService: checkout-canary     # Service que aponta só para os pods do canário
      stableService: checkout-stable
      analysis:
        templates: [{ templateName: taxa-de-sucesso }]
        startingStep: 1                  # começa após o primeiro setWeight
      steps:
        - setWeight: 5
        - pause: { duration: 10m }
        - setWeight: 25
        - pause: { duration: 20m }
        - setWeight: 50
        - pause: {}                      # promoção manual: kubectl argo rollouts promote checkout
O AnalysisTemplate define as métricas de guarda. Cada uma é medida a cada minuto, e duas medições fora do limiar abortam o rollout. As consultas filtram pelo rótulo do Service do canário, para que o conjunto estável não dilua o resultado.
apiVersion: argoproj.io/v1alpha1
kind: AnalysisTemplate
metadata:
  name: taxa-de-sucesso
spec:
  metrics:
    - name: taxa-de-sucesso
      interval: 1m
      failureLimit: 2
      successCondition: result[0] >= 0.99
      provider:
        prometheus:
          address: http://prometheus.monitoring:9090
          query: |
            sum(rate(http_requests_total{service="checkout-canary",status!~"5.."}[2m]))
            / sum(rate(http_requests_total{service="checkout-canary"}[2m]))
    - name: latencia-p99
      interval: 1m
      failureLimit: 2
      successCondition: result[0] < 0.8
      provider:
        prometheus:
          address: http://prometheus.monitoring:9090
          query: |
            histogram_quantile(0.99, sum by (le)
              (rate(http_request_duration_seconds_bucket{service="checkout-canary"}[2m])))
Desafios
Flags órfãs são o custo mais comum. Uma flag em 100 % há seis meses ainda é avaliada a cada requisição, ainda tem dois caminhos no código e ainda pode ser desligada por engano. A remoção precisa constar da definição de pronto do release, não de um backlog de limpeza.
Dez flags independentes produzem 1.024 combinações de caminhos, e nenhuma suíte de testes cobre todas. A prática viável é testar cada flag nos dois estados, testar a combinação que vai a produção e manter as flags curtas para que poucas coexistam.
Sessões presas em uma versão aparecem quando a avaliação muda no meio de um fluxo. Um usuário que começou o checkout na versão antiga e, após uma troca de semente, cai na nova pode encontrar um estado de sessão que a nova não reconhece. Avaliar a flag uma vez por sessão e guardar o resultado evita o problema. No canary, conexões persistentes como WebSocket ficam presas aos pods antigos até reconectar.
A entrega progressiva não protege o que não é observado. Um canário com métricas agregadas por serviço, sem distinção entre versões, aprova qualquer coisa.
Boas práticas
- Trate deploy e release como eventos separados e meça o tempo entre eles.
- Avalie flags por hash determinístico do identificador, da chave e de uma semente, nunca por sorteio.
- Dê a cada flag um dono, um tipo e uma data de remoção, e remova o caminho antigo no mesmo release que leva a flag a 100 %.
- Mantenha o esquema do banco compatível com as versões N e N+1 durante toda a janela de rollout.
- Defina métricas de guarda com limiar explícito e um limite de falhas maior que 1, medidas só nos pods do canário.
- Comece com um peso pequeno e uma pausa curta para falhas grosseiras, e reserve as pausas longas para os pesos maiores.
- Prefira o traffic router à proporção de réplicas quando a precisão do peso importar.
Conclusão
Entrega progressiva é a decisão de pagar em complexidade de execução para reduzir o alcance de cada erro. Flag determinística, rollout em passos e análise com limiares convertem o deploy de um evento binário em uma sequência de exposições crescentes, cada uma com um ponto de retorno.
A técnica não substitui testes nem compatibilidade de esquema: ela pressupõe que as duas versões convivam e que as métricas distingam uma da outra. Com essas condições atendidas, o rollback deixa de ser a única defesa e passa a ser uma consequência automática de uma métrica fora do limiar.
Referências
- Pete Hodgson, Feature Toggles (aka Feature Flags). https://martinfowler.com/articles/feature-toggles.html
- Martin Fowler, BlueGreenDeployment. https://martinfowler.com/bliki/BlueGreenDeployment.html
- Martin Fowler, CanaryRelease. https://martinfowler.com/bliki/CanaryRelease.html
- Argo Project, Argo Rollouts: Canary Deployment Strategy. https://argo-rollouts.readthedocs.io/en/stable/features/canary/
- Argo Project, Argo Rollouts: Analysis and Progressive Delivery. https://argo-rollouts.readthedocs.io/en/stable/features/analysis/
- Argo Project, Argo Rollouts: BlueGreen Deployment Strategy. https://argo-rollouts.readthedocs.io/en/stable/features/bluegreen/
Assuntos: DevOps, Kubernetes, Feature Flags, Continuous Delivery, Software Architecture
Continue lendo
- Probes, recursos e ciclo de vida de pods no Kubernetes — Como as probes de startup, liveness e readiness decidem reinício e tráfego, como requests e limits definem agendamento e classe de QoS, e como ler o kubectl describe quando um pod reinicia.
- Semântica de entrega em sistemas de mensageria: at-least-once, idempotência e dead-letter queues — Por que o broker entrega mais de uma vez, como o consumidor converte repetição em efeito único com uma tabela de mensagens processadas na mesma transação, e o que fazer com a mensagem que falha sempre.
- Estratégias de cache e invalidação em sistemas web — Como escolher entre cache-aside, read-through e write-behind, decidir entre TTL e invalidação por evento, conter o thundering herd com stale-while-revalidate e coalescing em Redis, e usar as camadas de cache do Next.js com revalidateTag.
Quer aplicar isto no seu sistema? Fale com a MFactor: contato ou WhatsApp +55 (19) 99778-9831.