Por que microsserviços “odeiam” transações?
Os limites naturais de microsserviços entram em choque com transações distribuídas e pedem compensações via SAGA.
Por Alexandre Martins · · 2 min de leitura
Projetar microsserviços é, em essência, lutar contra o acoplamento. E quando a gente tenta aplicar aquele velho modelo de transações ACID — atomicidade, consistência, isolamento e durabilidade — dentro de um ambiente distribuído, tudo começa a dar errado. Isso porque microsserviços foram feitos para viver isolados: cada um com seu próprio banco, linguagem, ciclo de vida. Esperar que todos ajam como uma transação única e sincronizada é pedir por problemas como latência, inconsistência e falhas misteriosas.
Se você vem do mundo relacional, seu primeiro impulso pode ser usar o famoso Two-Phase Commit (2PC), que tenta coordenar transações entre múltiplas partes. Funciona… em sistemas homogêneos. Mas no universo dos microsserviços, onde tudo é distribuído e a rede nem sempre colabora, o 2PC vira um pesadelo: exige bloqueios, trava recursos, e destrói a escalabilidade horizontal.
Então, o que fazer? A resposta moderna é o padrão SAGA.
Em vez de uma transação única e indivisível, SAGA quebra o processo em várias etapas locais, com “planos B” em caso de erro. Se uma parte falhar, os serviços anteriores sabem como desfazer suas ações. Nada de travar tudo esperando um “ok” global.
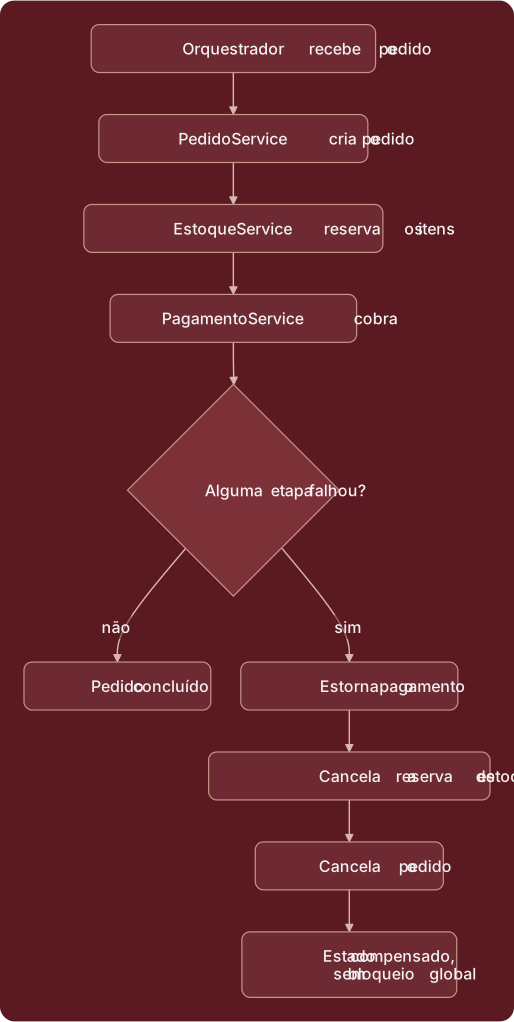
Ver o fluxograma em texto (Mermaid)
flowchart TD
  ini["Orquestrador recebe o pedido"] --> cria["PedidoService cria o pedido"]
  cria --> reserva["EstoqueService reserva os itens"]
  reserva --> cobra["PagamentoService cobra"]
  cobra --> falhou{"Alguma etapa falhou?"}
  falhou -- "não" --> fim["Pedido concluído"]
  falhou -- "sim" --> estorna["Estorna o pagamento"]
  estorna --> libera["Cancela a reserva de estoque"]
  libera --> cancela["Cancela o pedido"]
  cancela --> comp["Estado compensado,\nsem bloqueio global"]
Por exemplo, num fluxo de pedido em Java com Spring Boot, poderíamos ter:
@Service
public class PedidoSagaService {

    @Autowired
    private PedidoService pedidoService;

    @Autowired
    private EstoqueService estoqueService;

    @Autowired
    private PagamentoService pagamentoService;

    public void processarPedido(PedidoDTO pedido) {
        try {
            pedidoService.criarPedido(pedido);
            estoqueService.reservar(pedido.getItens());
            pagamentoService.cobrar(pedido.getPagamento());
        } catch (Exception e) {
            pagamentoService.estornar(pedido.getPagamento());
            estoqueService.cancelarReserva(pedido.getItens());
            pedidoService.cancelarPedido(pedido);
        }
    }
}
Essa abordagem se chama orquestração. Um serviço “maestro” coordena a execução e as compensações, caso algo saia errado. É fácil de debugar, auditar e monitorar, mas tem o custo de reduzir a autonomia dos serviços envolvidos.
Outra abordagem é a coreografia de eventos. Nela, cada serviço “dança conforme a música” dos eventos emitidos pelos outros. O PedidoService emite um PedidoCriadoEvent, que o EstoqueService consome e, por sua vez, publica um EstoqueReservadoEvent, e assim por diante. Tudo flui de forma assíncrona, desacoplada e eventualmente consistente.
É elegante? Sim. Mas quando algo quebra, encontrar o ponto de falha pode ser como procurar uma agulha num palheiro. A rastreabilidade vira um desafio real.
Para sistemas mais complexos, há ferramentas robustas como Temporal, Camunda ou Netflix Conductor. Elas permitem orquestrar workflows longos, com retries automáticos, controle de falhas e até compensações escritas em DSL ou código.
Exemplo básico usando o SDK do Temporal em Java:
@WorkflowInterface
public interface PedidoWorkflow {

    @WorkflowMethod
    void processarPedido(PedidoDTO pedido);
}

public class PedidoWorkflowImpl implements PedidoWorkflow {

    private final AtividadesPedido atividades = Workflow.newActivityStub(AtividadesPedido.class);

    @Override
    public void processarPedido(PedidoDTO pedido) {
        try {
            atividades.criarPedido(pedido);
            atividades.reservarEstoque(pedido.getItens());
            atividades.processarPagamento(pedido.getPagamento());
        } catch (Exception e) {
            atividades.estornarPagamento(pedido.getPagamento());
            atividades.cancelarEstoque(pedido.getItens());
            atividades.cancelarPedido(pedido);
        }
    }
}
Uma tentação comum é usar locking distribuído (tipo Redis ou Zookeeper) pra forçar uma “consistência forte”. Parece seguro, mas no fundo, isso só disfarça um monólito. Você acopla os serviços sem perceber, quebra a escalabilidade e ainda corre risco de falhas silenciosas se a rede cair.
A verdade é que, em microsserviços, transações tradicionais não escalam. A mentalidade precisa mudar: compense, não bloqueie. Construa fluxos resilientes, aceite consistência eventual e invista em observabilidade — com trace IDs, logs distribuídos e monitoramento real. E se você ainda precisa garantir atomicidade entre muitos serviços… talvez o problema esteja na sua modelagem de domínio.
No fim das contas, domínio bem desenhado ainda é a melhor transação que você pode fazer.
Assuntos: Microsserviços, SAGA, Transações Distribuídas, Java, Arquitetura de Software
Continue lendo
- Event Sourcing e CQRS: eventos como trilha auditável — Quando o histórico importa mais que o estado atual, Event Sourcing e CQRS oferecem rastreabilidade total com modelos separados de leitura e escrita.
- Governança e Automação de APIs em Larga Escala com Apigee — Apigee vai além de um gateway: centraliza governança, segurança e automação para APIs estratégicas em escala corporativa.
- Sua loja virtual é lenta? O que realmente pesa no carregamento — Core Web Vitals sem mistério e as causas mais comuns de lentidão em e-commerce.
Quer aplicar isto no seu sistema? Fale com a MFactor: contato ou WhatsApp +55 (19) 99778-9831.