Probes, recursos e ciclo de vida de pods no Kubernetes
Como as probes de startup, liveness e readiness decidem reinício e tráfego, como requests e limits definem agendamento e classe de QoS, e como ler o kubectl describe quando um pod reinicia.
Por Alexandre Martins · · 8 min de leitura
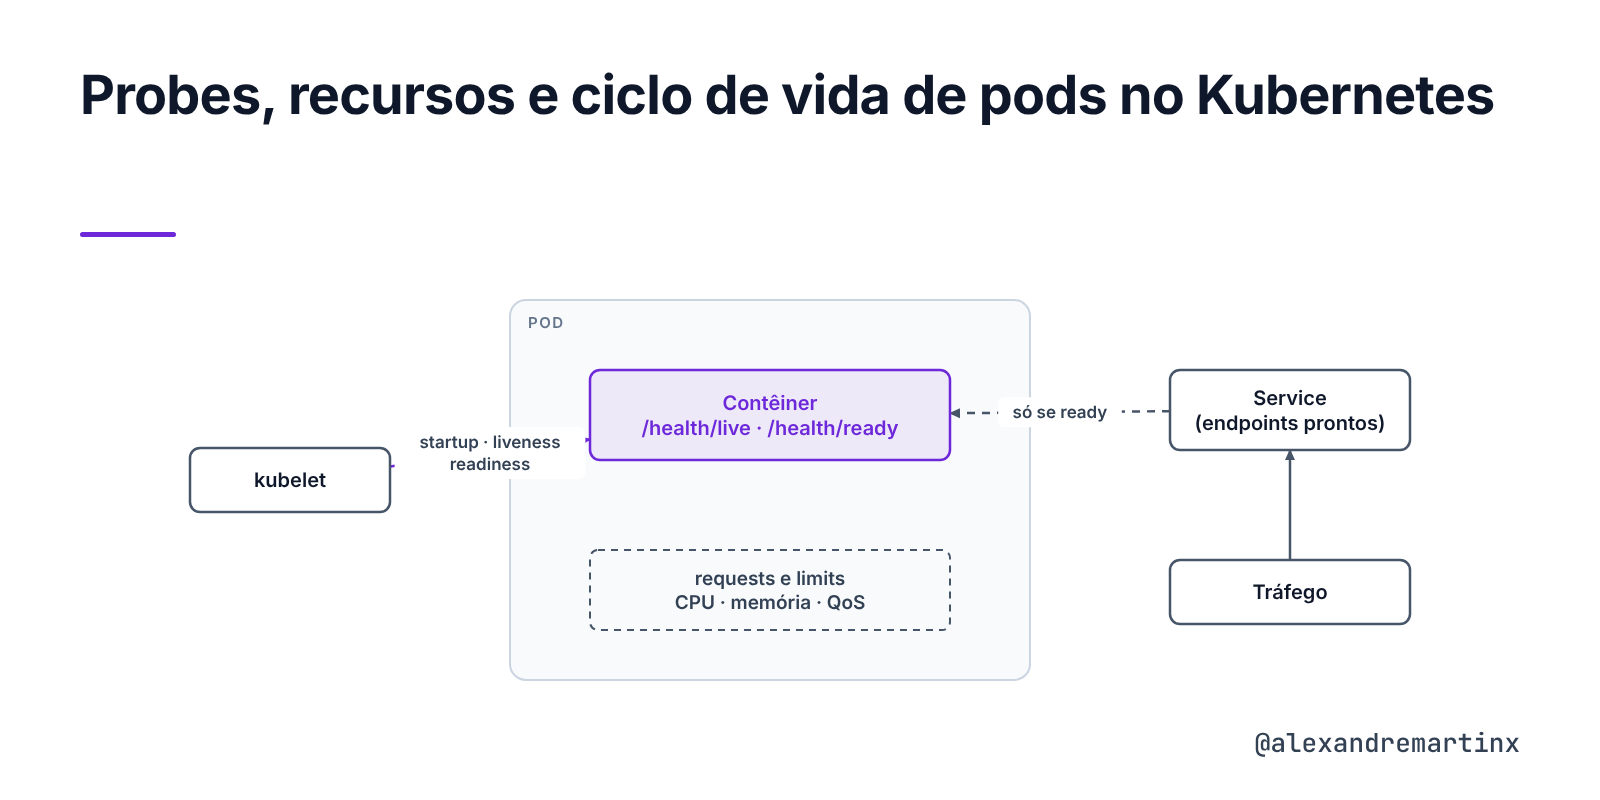
Considere um serviço de pedidos em Java com três réplicas em um Deployment. Uma réplica entra em deadlock no pool de conexões e continua aceitando conexões TCP sem responder. Outra acaba de iniciar, ainda carrega o contexto do Spring e já recebe tráfego do Service. A terceira verifica o banco na checagem de vitalidade, e uma oscilação do banco derruba as três ao mesmo tempo.
Sem configuração explícita, o Kubernetes trata qualquer contêiner em execução como saudável e pronto, e qualquer consumo de CPU e memória como aceitável. Probes e recursos corrigem essas duas suposições. Configurados errado, produzem o oposto do que prometem: reinícios em cascata, pods que nunca ficam prontos e processos mortos por falta de memória no pico.
Como informar ao kubelet quando um contêiner deve ser reiniciado, quando deve receber tráfego e quanto de CPU e memória pode consumir, sem transformar uma falha externa em reinícios em cascata?
Ciclo de vida do pod e do contêiner
A documentação do Kubernetes define cinco fases para o pod: Pending, Running, Succeeded, Failed e Unknown. O estado que importa na operação diária está um nível abaixo, no contêiner, que alterna entre Waiting, Running e Terminated.
Com restartPolicy Always, o padrão, o kubelet reinicia qualquer contêiner que termine, com atraso exponencial que começa em 10 segundos e chega a 5 minutos, o CrashLoopBackOff do kubectl. Cada reinício incrementa Restart Count e preserva o estado anterior em Last State, com a razão do término e o código de saída.
No encerramento, o kubelet envia SIGTERM ao processo principal, espera terminationGracePeriodSeconds (30 segundos por padrão) e envia SIGKILL ao que restar.
As três probes e seus efeitos
Uma probe é um diagnóstico que o kubelet executa periodicamente no contêiner por um de quatro mecanismos: exec, httpGet, tcpSocket e grpc. No httpGet, qualquer status entre 200 e 399 conta como sucesso. Os efeitos são distintos:
- Startup: enquanto não tiver sucesso, as outras duas não executam. Se falhar failureThreshold vezes seguidas, o contêiner é reiniciado. Existe para inicializações lentas, como a de uma JVM.
- Liveness: falhas consecutivas acima do limiar fazem o kubelet matar e reiniciar o contêiner, respeitando o terminationGracePeriodSeconds. Deve indicar falha irrecuperável do processo, como deadlock.
- Readiness: a falha remove o IP do pod dos EndpointSlices dos Services que o selecionam, e o sucesso o devolve. Não há reinício, e ela roda durante toda a vida do contêiner.
Cinco parâmetros controlam cada probe, com os seguintes valores padrão: initialDelaySeconds 0, periodSeconds 10, timeoutSeconds 1, successThreshold 1 e failureThreshold 3. O successThreshold precisa ser 1 em liveness e startup. A janela de uma startup probe é failureThreshold multiplicado por periodSeconds: 24 falhas com período de 5 segundos dão 120 segundos antes do primeiro reinício.
O antipadrão mais frequente é a liveness que depende de um serviço externo. A documentação do Kubernetes avisa que implementações incorretas levam a falhas em cascata, e a do Spring Boot é explícita: se o banco cai, o Kubernetes reinicia todas as instâncias ao mesmo tempo. Dependências externas pertencem à readiness, e mesmo ali a inclusão exige critério. Uma dependência compartilhada por todas as réplicas tira o serviço inteiro do ar quando falha, e pode ser melhor tratá-la com circuit breaker no chamador.
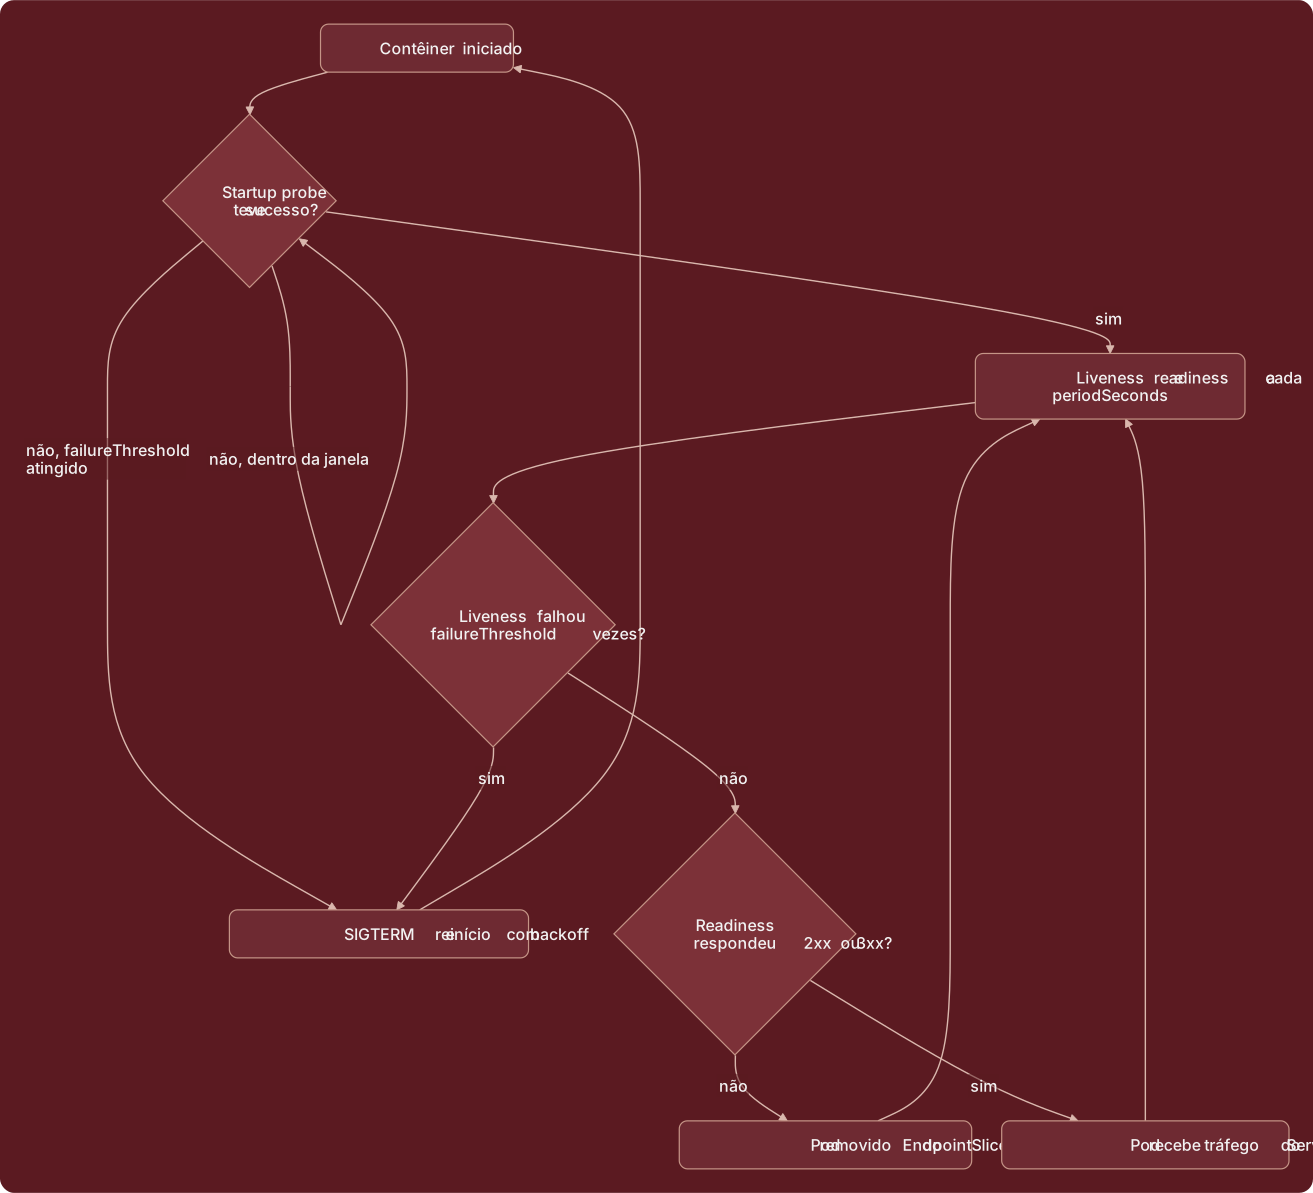
Ver o fluxograma em texto (Mermaid)
flowchart TD
  inicio["Contêiner iniciado"] --> startup{"Startup probe\nteve sucesso?"}
  startup -- "não, dentro da janela" --> startup
  startup -- "não, failureThreshold atingido" --> sigterm["SIGTERM e reinício com backoff"]
  startup -- "sim" --> ciclo["Liveness e readiness a cada periodSeconds"]
  ciclo --> liveness{"Liveness falhou\nfailureThreshold vezes?"}
  liveness -- "sim" --> sigterm
  sigterm --> inicio
  liveness -- "não" --> readiness{"Readiness\nrespondeu 2xx ou 3xx?"}
  readiness -- "não" --> fora["Pod removido do EndpointSlice"]
  readiness -- "sim" --> dentro["Pod recebe tráfego do Service"]
  fora --> ciclo
  dentro --> ciclo
Requests, limits e classes de QoS
O request é o que o kube-scheduler usa para escolher o nó: a soma dos requests dos pods não pode ultrapassar a capacidade alocável. O limit é o que o kubelet e o kernel aplicam em tempo de execução. Se só o limit for declarado, o Kubernetes copia o valor para o request.
CPU é medida em cores ou millicores, e 500m equivale a meio core em qualquer máquina. O limite de CPU é imposto por throttling: o kernel restringe o acesso ao processador quando o contêiner esgota a cota do período do CFS (Completely Fair Scheduler). A métrica container_cpu_cfs_throttled_periods_total do cAdvisor é onde isso aparece.
Memória é medida em bytes, com sufixos binários como Mi e Gi, e o limite é imposto pelo kernel com OOM kill. O contêiner que ultrapassa o limite sob pressão é encerrado com razão OOMKilled e código de saída 137, e o restartPolicy decide o reinício. Na JVM, o heap precisa caber no limite com folga para metaspace e threads, e -XX:MaxRAMPercentage faz esse ajuste a partir do cgroup.
A relação entre request e limit define a classe de QoS (Quality of Service), que decide a ordem de evicção sob pressão do nó. Guaranteed exige request igual a limit em CPU e memória para todos os contêineres. Burstable é qualquer pod com ao menos um request ou limit que não cumpra esse critério. BestEffort é o pod sem nada declarado, e sai primeiro. Memória com request igual a limit evita evicção por consumo acima do request. Para CPU, deixar o limit de fora elimina o throttling e aproveita ciclos ociosos do nó, ao custo de perder a classe Guaranteed.
Exemplo: Deployment com as três probes e recursos
A startup probe do manifesto a seguir reutiliza o endpoint de liveness e concede 120 segundos de inicialização. A liveness tolera 30 segundos de falha e a readiness tira o pod do Service após 10 segundos.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: pedidos
spec:
  replicas: 3
  selector:
    matchLabels:
      app: pedidos
  template:
    metadata:
      labels:
        app: pedidos
    spec:
      terminationGracePeriodSeconds: 40
      containers:
        - name: pedidos
          image: registry.exemplo.com/pedidos:1.8.2
          ports:
            - containerPort: 8080
          resources:
            requests:
              cpu: 500m
              memory: 768Mi
            limits:
              memory: 768Mi
          startupProbe:
            httpGet: { path: /actuator/health/liveness, port: 8080 }
            periodSeconds: 5
            failureThreshold: 24     # janela de 120 s para a JVM iniciar
          livenessProbe:
            httpGet: { path: /actuator/health/liveness, port: 8080 }
            periodSeconds: 10
            timeoutSeconds: 3
            failureThreshold: 3      # reinício após 30 s de falhas seguidas
          readinessProbe:
            httpGet: { path: /actuator/health/readiness, port: 8080 }
            periodSeconds: 5
            timeoutSeconds: 3
            failureThreshold: 2      # fora do Service após 10 s
Os 40 segundos de terminationGracePeriodSeconds acomodam o encerramento gracioso da aplicação. Sem limite de CPU e com memória igual nos dois campos, o pod fica na classe Burstable por decisão de projeto.
Endpoint de saúde com Spring Boot Actuator
O Spring Boot gerencia dois estados de disponibilidade, LivenessState e ReadinessState, e os expõe em /actuator/health/liveness e /actuator/health/readiness como grupos de saúde, habilitados automaticamente em ambiente Kubernetes. Por padrão nenhum outro indicador entra neles, e a inclusão do banco na readiness é uma decisão explícita:
management:
  endpoint:
    health:
      probes:
        enabled: true                     # obrigatório fora do Kubernetes
      group:
        liveness:
          include: "livenessState"        # só o estado interno do processo
        readiness:
          include: "readinessState,db"    # o banco entra na prontidão, nunca na vitalidade
server:
  shutdown: graceful                      # conclui as requisições em curso após o SIGTERM
spring:
  lifecycle:
    timeout-per-shutdown-phase: 30s
A readiness devolve 503 quando o DataSource falha a validação, e o pod sai do Service sem reinício. A liveness fica só com o estado interno, que o Spring marca como BROKEN quando o contexto da aplicação falha. No encerramento, o ReadinessState passa a REFUSING_TRAFFIC e, com server.shutdown graceful, o servidor recusa conexões novas e conclui as requisições em curso até o limite configurado.
Leitura do kubectl describe
O kubectl describe concentra a evidência de um reinício no estado do contêiner e nos eventos. O trecho a seguir é de uma réplica que ficou sem memória e, depois de reiniciar, falhou a liveness por timeout:
Containers:
  pedidos:
    State:          Running
    Last State:     Terminated
      Reason:       OOMKilled
      Exit Code:    137
    Ready:          False
    Restart Count:  4
QoS Class:          Burstable
Events:
  Type     Reason     Age                  From     Message
  ----     ------     ----                 ----     -------
  Warning  Unhealthy  3m12s (x6 over 18m)  kubelet  Readiness probe failed: HTTP probe failed with statuscode: 503
  Warning  Unhealthy  2m40s (x3 over 3m)   kubelet  Liveness probe failed: Get "http://10.244.1.17:8080/actuator/health/liveness": context deadline exceeded
  Normal   Killing    2m40s                kubelet  Container pedidos failed liveness probe, will be restarted
Last State com razão OOMKilled e código 137 diz que o kernel matou o processo por memória, não a probe. Restart Count 4 indica reinícios repetidos, com atraso exponencial em curso. O Unhealthy de readiness com 503 vem da aplicação, que respondeu e se declarou indisponível. O de liveness com context deadline exceeded vem do kubelet, que não recebeu resposta dentro de timeoutSeconds, e o Killing confirma que o reinício veio da liveness. A contagem x6 over 18m mostra que os eventos são agregados, e a ordem real precisa ser lida pelos tempos.
Desafios
Os parâmetros padrão são apertados para a JVM. Um timeoutSeconds de 1 segundo falha durante uma pausa de garbage collection, e três falhas em 30 segundos reiniciam um processo saudável sob carga. Timeouts de 3 a 5 segundos e failureThreshold calibrado pela latência observada são um ponto de partida mais seguro.
O throttling de CPU é invisível no kubectl. Em uma JVM, as threads de garbage collection e JIT consomem a cota de 1 core em poucos milissegundos de cada período de 100 ms. O sintoma é latência alta com uso médio de CPU baixo.
A remoção do pod dos EndpointSlices e o SIGTERM acontecem em paralelo, e a propagação para os kube-proxy leva segundos. Um preStop com pausa curta, ou o encerramento gracioso da aplicação, cobre essa janela. Sem isso, cada deploy produz conexões recusadas.
Por fim, probes e recursos não substituem autoscaling. A readiness tira do Service a réplica sobrecarregada, mas não cria outra. Sem um HorizontalPodAutoscaler, uma carga acima da capacidade derruba as réplicas em sequência.
Boas práticas
- Configure as três probes em todo Deployment e prefira uma startup probe a um initialDelaySeconds longo na liveness.
- Mantenha a liveness restrita ao estado interno do processo e nunca inclua banco, cache ou API externa nela.
- Inclua na readiness só dependências sem as quais a réplica não atende, e decida caso a caso as compartilhadas.
- Declare request de CPU e request igual a limit de memória, e ajuste o heap da JVM ao limite do cgroup.
- Defina timeoutSeconds e failureThreshold a partir da latência observada em produção, não dos valores padrão.
- Habilite o encerramento gracioso na aplicação e dimensione terminationGracePeriodSeconds acima do tempo que ele leva.
- Leia Last State, Restart Count e os eventos antes de alterar parâmetros, e monitore os períodos de CPU estrangulados.
Conclusão
Probes e recursos são declarações de contrato entre a aplicação e o kubelet. A startup diz quanto tempo o processo precisa para começar, a liveness diz quando ele deve ser substituído e a readiness diz quando pode receber tráfego. Requests dizem ao scheduler o que reservar e limits dizem ao kernel o que impor. Confundir esses sinais produz as falhas que eles existem para evitar.
A decisão de projeto está em separar falha do processo de falha de dependência, e em aceitar que memória e CPU se comportam de forma diferente sob limite. Com essas distinções no manifesto e no endpoint de saúde, o Kubernetes reinicia só o que travou, tira do balanceamento só o que não está pronto e agenda com base em números reais.
Referências
- Kubernetes, Pod Lifecycle. https://kubernetes.io/docs/concepts/workloads/pods/pod-lifecycle/
- Kubernetes, Liveness, Readiness, and Startup Probes. https://kubernetes.io/docs/concepts/configuration/liveness-readiness-startup-probes/
- Kubernetes, Resource Management for Pods and Containers. https://kubernetes.io/docs/concepts/configuration/manage-resources-containers/
- Kubernetes, Pod Quality of Service Classes. https://kubernetes.io/docs/concepts/workloads/pods/pod-qos/
- Spring Boot, Actuator Endpoints, seção Kubernetes Probes. https://docs.spring.io/spring-boot/reference/actuator/endpoints.html
Assuntos: Kubernetes, DevOps, Spring Boot, Site Reliability Engineering, Cloud Native
Continue lendo
- Entrega progressiva: feature flags, canary e blue-green — Como separar deploy de release com flags avaliadas por hash determinístico, escolher entre blue-green e canary, e deixar métricas de guarda decidirem a promoção ou o rollback com Argo Rollouts.
- Semântica de entrega em sistemas de mensageria: at-least-once, idempotência e dead-letter queues — Por que o broker entrega mais de uma vez, como o consumidor converte repetição em efeito único com uma tabela de mensagens processadas na mesma transação, e o que fazer com a mensagem que falha sempre.
- Kubernetes não é para todo mundo, e tudo bem — Como decidimos se um projeto precisa de orquestração de containers ou se uma estrutura mais simples resolve melhor.
Quer aplicar isto no seu sistema? Fale com a MFactor: contato ou WhatsApp +55 (19) 99778-9831.