Observabilidade distribuída com OpenTelemetry: traces, métricas e logs correlacionados
Como propagar o contexto de um trace entre serviços com o W3C Trace Context, ligar logs e métricas ao mesmo trace_id, montar o pipeline com SDK e Collector e decidir o que amostrar sem perder a cauda da latência.
Por Alexandre Martins · · 7 min de leitura
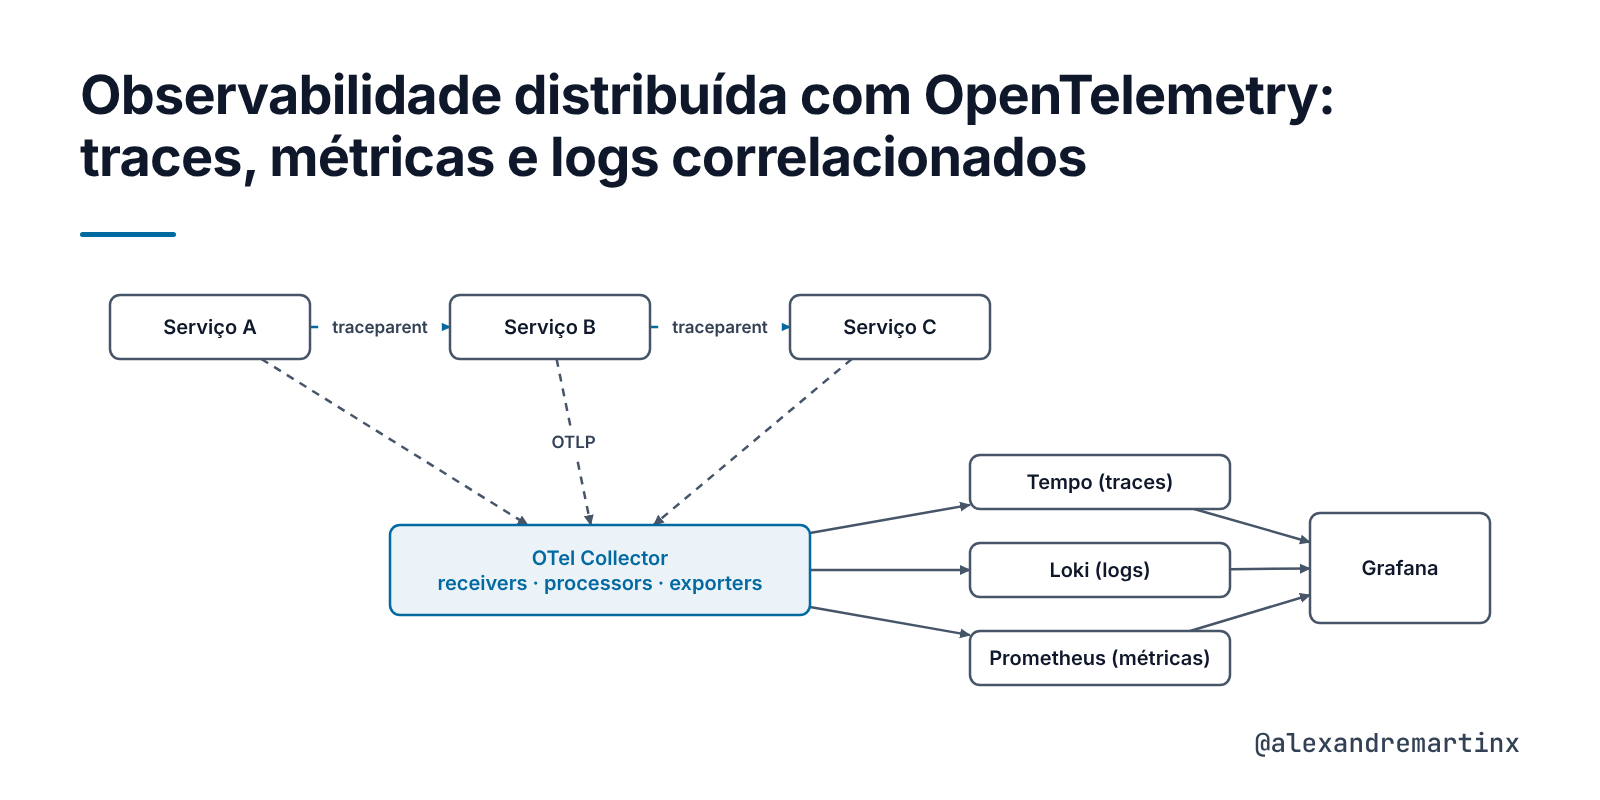
Considere uma consulta de pedido que passa por um gateway, chega a um serviço em Node, consulta o PostgreSQL e chama um serviço de estoque. A resposta leva 4 segundos. Cada serviço registra a própria linha de log, sem referência às outras.
Cada serviço tem métricas de latência próprias, mas nenhuma diz qual requisição demorou nem em qual chamada o tempo foi gasto. A investigação é feita por janela de horário e por palpite.
O que falta é um identificador que nasça na borda, viaje com a requisição por todos os saltos e apareça em cada span, cada log e, quando possível, cada medição. O OpenTelemetry (OTel) padroniza esse identificador, o formato em que ele viaja e o pipeline que o coleta.
Como fazer com que traces, métricas e logs de serviços distintos descrevam a mesma requisição, e como coletar isso em volume sem pagar pelo armazenamento de tudo?
Os três sinais e a correlação
O OpenTelemetry define três sinais principais. O trace é o caminho de uma requisição pela aplicação, composto por spans com nome, intervalo de tempo, atributos, status e referência ao span pai. A métrica é uma medição agregada em tempo de execução, como um contador de requisições ou um histograma de latência. O log é o registro de um evento.
A correlação se dá por dois identificadores. O trace_id, de 16 bytes, é o mesmo em todos os spans de uma requisição. O span_id, de 8 bytes, identifica cada operação. Um log emitido dentro de um span recebe os dois como campos. Métricas são agregadas e não carregam identificadores, mas podem anexar exemplars: amostras com o trace_id de uma requisição que caiu naquele bucket do histograma.
Com isso, a investigação inverte. A métrica p99 mostra a degradação e o exemplar leva a um trace lento. O trace mostra em que span o tempo foi gasto, e os logs daquele span dizem por quê.
Propagação de contexto com o W3C Trace Context
A recomendação W3C Trace Context, de 2021, define dois cabeçalhos HTTP. O traceparent carrega quatro campos separados por hífen: versão (2 caracteres hexadecimais), trace-id (32), parent-id (16) e trace-flags (2). Um valor da própria especificação é 00-0af7651916cd43dd8448eb211c80319c-b7ad6b7169203331-01, em que o 01 final indica trace amostrado. O tracestate carrega dados específicos de fornecedor.
O serviço que recebe a requisição extrai o cabeçalho e cria um span filho com o mesmo trace_id e um novo span_id. Nas chamadas que fizer, injeta um traceparent atualizado, com o próprio span_id no campo parent-id. Em HTTP, a instrumentação automática de cliente e servidor faz isso sem código da aplicação.
Em mensageria o contexto vai nos metadados da mensagem: headers de registro no Kafka, message attributes no SQS, headers de propriedade no RabbitMQ. O span do consumidor fica ligado ao do produtor por um link, porque o processamento assíncrono não é filho direto da requisição original.
Arquitetura: SDK, instrumentação automática e Collector
O SDK roda dentro do processo. Ele cria spans, agrega métricas, recebe logs pela ponte da biblioteca de logging e exporta tudo pelo OTLP (OpenTelemetry Protocol), por gRPC na porta 4317 ou por HTTP na 4318. A instrumentação automática intercepta bibliotecas conhecidas, como o módulo http, Express, o driver pg e o pino, e cria spans conforme as convenções semânticas.
O Collector é um processo separado, sidecar ou DaemonSet, que recebe a telemetria dos SDKs e a encaminha aos backends. Receivers aceitam dados em um protocolo. Processors transformam, filtram, amostram ou limitam memória. Exporters enviam a um destino. Um pipeline no bloco service liga os três para cada sinal, e um componente declarado só funciona dentro de um pipeline.
Os backends abertos mais comuns são o Tempo para traces, o Prometheus para métricas e o Loki para logs, consultados pelo Grafana, que navega entre eles pelo trace_id. Trocar o backend é trocar um exporter, não um deploy de todos os serviços.
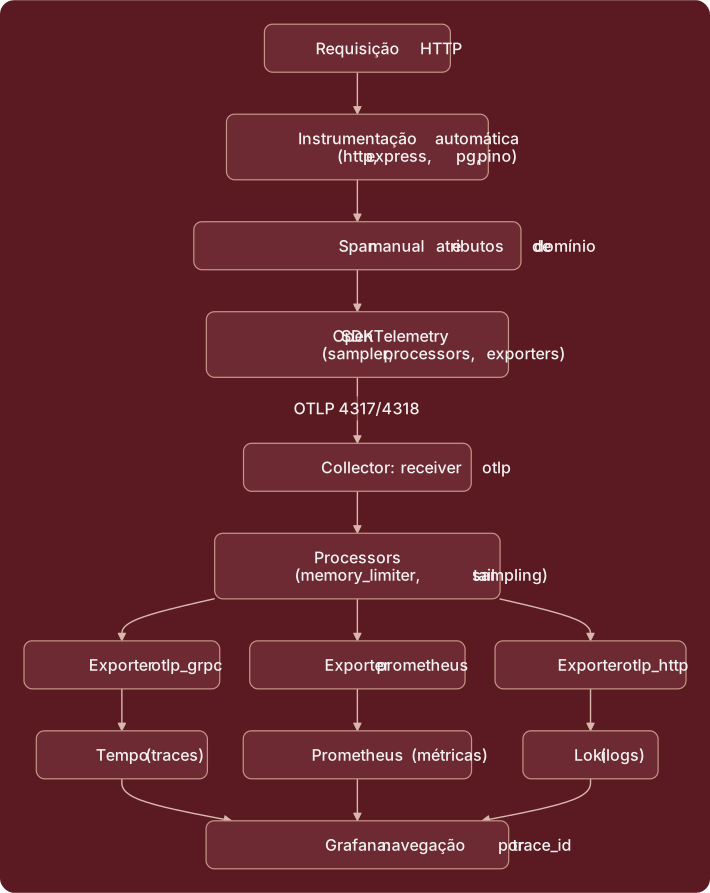
Ver o fluxograma em texto (Mermaid)
flowchart LR
  req["Requisição HTTP"] --> auto["Instrumentação automática\n(http, express, pg, pino)"]
  auto --> manual["Span manual e atributos de domínio"]
  manual --> sdk["SDK OpenTelemetry\n(sampler, processors, exporters)"]
  sdk -- "OTLP 4317/4318" --> receiver["Collector: receiver otlp"]
  receiver --> processor["Processors\n(memory_limiter, tail sampling)"]
  processor --> expTraces["Exporter otlp_grpc"]
  processor --> expMetrics["Exporter prometheus"]
  processor --> expLogs["Exporter otlp_http"]
  expTraces --> tempo["Tempo (traces)"]
  expMetrics --> prom["Prometheus (métricas)"]
  expLogs --> loki["Loki (logs)"]
  tempo --> grafana["Grafana: navegação por trace_id"]
  prom --> grafana
  loki --> grafana
Métricas RED e USE, percentis e amostragem
Para serviços, o método RED de Tom Wilkie define três métricas: Rate (requisições por segundo), Errors (quantas falharam) e Duration (quanto levaram). Para recursos como CPU, disco e pools, o método USE de Brendan Gregg mede Utilization, Saturation e Errors.
A duração precisa ser um histograma, não uma média. Em cem requisições com 99 em 50 ms e uma em 5 s, a média é 99,5 ms e o p99 é 5 s. A média esconde a cauda, e a cauda é onde está o usuário que reclamou.
A amostragem decide quais traces são exportados. No head sampling a decisão é tomada na criação do span raiz, por uma razão sobre o trace_id, e os filhos a herdam pelo trace-flags. É barato e previsível, mas não sabe se o trace vai terminar em erro. No tail sampling a decisão é tomada no Collector depois que todos os spans chegaram, com políticas por latência, status ou probabilidade. Ele preserva os traces que importam ao custo de manter estado: todos os spans de um trace precisam chegar à mesma instância do Collector, o que pede balanceamento por trace_id.
Exemplo em Node com TypeScript
O arquivo de instrumentação é carregado antes da aplicação, com node --import ./instrumentation.js:
import { NodeSDK } from '@opentelemetry/sdk-node';
import { getNodeAutoInstrumentations } from '@opentelemetry/auto-instrumentations-node';
import { OTLPTraceExporter } from '@opentelemetry/exporter-trace-otlp-proto';
import { OTLPMetricExporter } from '@opentelemetry/exporter-metrics-otlp-proto';
import { OTLPLogExporter } from '@opentelemetry/exporter-logs-otlp-proto';
import { PeriodicExportingMetricReader } from '@opentelemetry/sdk-metrics';
import { BatchLogRecordProcessor } from '@opentelemetry/sdk-logs';
import { ParentBasedSampler, TraceIdRatioBasedSampler } from '@opentelemetry/sdk-trace-base';
import { resourceFromAttributes } from '@opentelemetry/resources';
import { ATTR_SERVICE_NAME } from '@opentelemetry/semantic-conventions';

const coletor = process.env.OTEL_EXPORTER_OTLP_ENDPOINT ?? 'http://localhost:4318';

const sdk = new NodeSDK({
  resource: resourceFromAttributes({
    [ATTR_SERVICE_NAME]: 'pedidos-api',
  }),
  // Head sampling: 20% dos traces, decidido na raiz e herdado pelos filhos.
  sampler: new ParentBasedSampler({ root: new TraceIdRatioBasedSampler(0.2) }),
  traceExporter: new OTLPTraceExporter({ url: `${coletor}/v1/traces` }),
  metricReaders: [
    new PeriodicExportingMetricReader({ exporter: new OTLPMetricExporter({ url: `${coletor}/v1/metrics` }) }),
  ],
  logRecordProcessors: [
    new BatchLogRecordProcessor({ exporter: new OTLPLogExporter({ url: `${coletor}/v1/logs` }) }),
  ],
  // http, express, pg e pino instrumentados sem alterar a aplicação.
  instrumentations: [getNodeAutoInstrumentations()],
});

sdk.start();
process.on('SIGTERM', () => sdk.shutdown().finally(() => process.exit(0)));
A aplicação usa a API do OTel só onde a instrumentação automática não enxerga: a operação de negócio. O pino não precisa de nada, porque a instrumentação injeta trace_id, span_id e trace_flags em cada registro emitido dentro de um span.
import express from 'express';
import pino from 'pino';
import { trace, SpanStatusCode } from '@opentelemetry/api';
import { buscarPedido } from './repositorio-pedidos';

const log = pino();
const tracer = trace.getTracer('pedidos-api');
const app = express();

app.get('/pedidos/:id', async (req, res) => {
  // Span filho do span HTTP criado pela instrumentação automática.
  await tracer.startActiveSpan('pedidos.consultar', async (span) => {
    span.setAttribute('pedido.id', req.params.id);        // identificador fica no span, nunca em métrica
    try {
      const pedido = await buscarPedido(req.params.id);   // a consulta ao PostgreSQL vira span filho (pg)
      if (!pedido) {
        log.warn({ pedidoId: req.params.id }, 'pedido não encontrado');
        res.status(404).end();
        return;
      }
      res.json(pedido);
    } catch (erro) {
      span.recordException(erro as Error);
      span.setStatus({ code: SpanStatusCode.ERROR });
      log.error({ err: erro }, 'falha ao consultar pedido');
      res.status(500).end();
    } finally {
      span.end();
    }
  });
});

app.listen(8080);
Uma linha de log desse código traz o contexto do trace sem que a aplicação o tenha escrito:
{"level":40,"time":1792843203421,"pid":17,"hostname":"pedidos-api-7c9d4f6b8-x2k4q","trace_id":"0af7651916cd43dd8448eb211c80319c","span_id":"b7ad6b7169203331","trace_flags":"01","pedidoId":"9f3c","msg":"pedido não encontrado"}Configuração mínima do Collector
O Collector a seguir recebe OTLP nas duas portas, protege a própria memória e entrega cada sinal ao seu backend. O Loki aceita OTLP nativamente, e o Prometheus coleta as métricas do endpoint exposto pelo exporter.
receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317
      http:
        endpoint: 0.0.0.0:4318
processors:
  memory_limiter:
    check_interval: 1s
    limit_mib: 1500
    spike_limit_mib: 300
exporters:
  otlp_grpc:                          # traces para o Tempo
    endpoint: tempo:4317
    tls:
      insecure: true
    sending_queue:
      batch:
  otlp_http:                          # logs para o Loki
    endpoint: http://loki:3100/otlp
    sending_queue:
      batch:
  prometheus:
    endpoint: 0.0.0.0:8889

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter]
      exporters: [otlp_grpc]
    metrics:
      receivers: [otlp]
      processors: [memory_limiter]
      exporters: [prometheus]
    logs:
      receivers: [otlp]
      processors: [memory_limiter]
      exporters: [otlp_http]
Versões antigas do Collector usam os nomes otlp e otlphttp para esses exporters e um processor batch separado. O tail sampling entra como processor tail_sampling no pipeline de traces, com decision_wait de 30 segundos por padrão.
Desafios
A cardinalidade é o custo escondido das métricas. Cada combinação de valores de atributo gera uma série temporal, e um identificador de cliente multiplica as séries por milhões. Identificadores pertencem aos spans e aos logs. Rotas HTTP entram com o padrão, /pedidos/{id}, e não com o valor.
O volume de traces cresce com o tráfego e com o número de serviços por requisição. Com head sampling, os erros raros têm a mesma chance de descarte que o resto. A combinação usual é head sampling generoso no SDK e tail sampling no Collector com política que preserva erros e latências altas.
A propagação depende de toda a cadeia. Uma biblioteca HTTP sem instrumentação, um worker que lê da fila sem extrair o contexto ou um proxy que remove cabeçalhos desconhecidos quebra o trace. A verificação precisa ser feita por salto.
Por fim, o Collector é um componente a operar, com memória finita, filas que enchem quando o backend demora e versões que renomeiam componentes. O memory_limiter e o monitoramento das métricas do próprio Collector fazem parte da instalação.
Boas práticas
- Carregue o SDK antes de qualquer módulo da aplicação e defina service.name e service.version no recurso.
- Propague o contexto pelo traceparent em HTTP e pelos metadados da mensagem em filas, e verifique a continuidade por salto.
- Mantenha identificadores de alta cardinalidade em atributos de span e em logs, e registre rotas HTTP pelo padrão, não pelo valor.
- Meça duração com histogramas e alerte por percentil, nunca por média.
- Comece com head sampling por razão e acrescente tail sampling no Collector quando os erros raros começarem a sumir.
- Envie todos os sinais ao Collector por OTLP e troque backends no exporter, não na aplicação.
- Trate o Collector como serviço de produção, com memory_limiter, filas dimensionadas e métricas monitoradas.
Conclusão
Observabilidade distribuída é a capacidade de responder a uma pergunta sobre uma requisição específica a partir de dados agregados. O trace_id torna isso possível, e o OpenTelemetry padroniza como ele nasce, como viaja no traceparent e como chega a spans, logs e exemplars. O SDK e a instrumentação automática resolvem a maior parte do trabalho no processo, e o Collector resolve a entrega.
As decisões de projeto ficam nas bordas: quais atributos entram em métricas e quais ficam em spans, quanto amostrar e onde, e quais saltos ainda não propagam contexto. Com essas respostas definidas, a investigação de uma requisição lenta deixa de ser correlação manual de horários e passa a ser uma consulta por identificador.
Referências
- W3C, Trace Context (Recommendation, 2021). https://www.w3.org/TR/trace-context/
- OpenTelemetry, Collector configuration. https://opentelemetry.io/docs/collector/configuration/
- OpenTelemetry, Getting started with Node.js. https://opentelemetry.io/docs/languages/js/getting-started/nodejs/
- OpenTelemetry, Sampling. https://opentelemetry.io/docs/concepts/sampling/
- Tom Wilkie, The RED Method: How to Instrument Your Services. https://grafana.com/blog/2018/08/02/the-red-method-how-to-instrument-your-services/
- Brendan Gregg, The USE Method. https://www.brendangregg.com/usemethod.html
Assuntos: OpenTelemetry, Observability, Node.js, TypeScript, Distributed Systems
Continue lendo
- Rate limiting distribuído: algoritmos, implementação atômica e políticas de falha — Como escolher entre janela fixa, janela deslizante, token bucket e leaky bucket, manter o contador correto com várias réplicas usando um script Lua no Redis, responder 429 com os cabeçalhos RateLimit e decidir o que fazer quando o Redis cai.
- Semântica de entrega em sistemas de mensageria: at-least-once, idempotência e dead-letter queues — Por que o broker entrega mais de uma vez, como o consumidor converte repetição em efeito único com uma tabela de mensagens processadas na mesma transação, e o que fazer com a mensagem que falha sempre.
- Transactional Outbox: publicação confiável de eventos a partir do banco de dados — Como gravar o evento na mesma transação do agregado e entregá-lo ao broker por polling ou por captura do log de transações, com garantia at-least-once, ordem por agregado e deduplicação no consumidor.
Quer aplicar isto no seu sistema? Fale com a MFactor: contato ou WhatsApp +55 (19) 99778-9831.